O Claude Haiku 5.5 saiu em 7 de outubro de 2026. É o primeiro Haiku com ajuste de esforço. Deixe esse controle quieto e você recebe o medium. No Intelligence Index da Artificial Analysis, o medium marca 34. A versão dos materiais de lançamento é o max, e o max marca 43.
Esses 43 são 26 pontos acima do Haiku 4.5, que fica em 17, e 13 pontos atrás do Sonnet 5.5 no máximo, que marca 56. A tabela de lançamento não nomeia o esforço nas células do Haiku. Uma nota de Briefcase ou de uso de computador nessa tabela é um resultado publicado. É o topo da escada. De fábrica, você está dois degraus abaixo.
Na API o id é claude-haiku-5-5. O contexto é de 1 milhão de tokens, acima dos 200.000. A saída máxima é de 128.000, acima dos 64.000. A entrada é texto e imagem. A saída é texto. O corte de conhecimento confiável é junho de 2026. O adaptive thinking vem ligado. O mesmo texto conta como cerca de 30% mais tokens do que no Haiku 4.5, então um max_tokens calibrado para o modelo antigo pode parar depois do pensamento e antes da resposta.
A versão do lançamento é o topo da escada
A Artificial Analysis rodou os cinco esforços. O high, em 38, é o máximo da GPT-6 Luna. O max, em 43, fica logo à frente do GLM-5.3 Flash em 42 e do Gemini 3.8 Flash em 41, e logo atrás do Kimi K3 em 44.
| Esforço | Intelligence Index |
|---|---|
| Low | 29 |
| Medium | 34 |
| High | 38 |
| Xhigh | 41 |
| Max | 43 |
Os tokens decidem se a versão do lançamento vale a pena ligar. No max, uma tarefa do índice usa cerca de 162.000 tokens de saída, cerca de três vezes o máximo da Luna, e mais do que o Opus 5.5 no máximo. A maior parte disso é raciocínio. O passo do xhigh em 41 para o max em 43 são 2 pontos por cerca de 1,8 vez os tokens. O high chega aos 38 da Luna com cerca de 55.000 tokens de saída, contra cerca de 50.000 da Luna. A rodada completa do índice no max produziu 440 milhões de tokens de saída, contra uma mediana de 100 milhões. A rodada do low produziu 32 milhões.
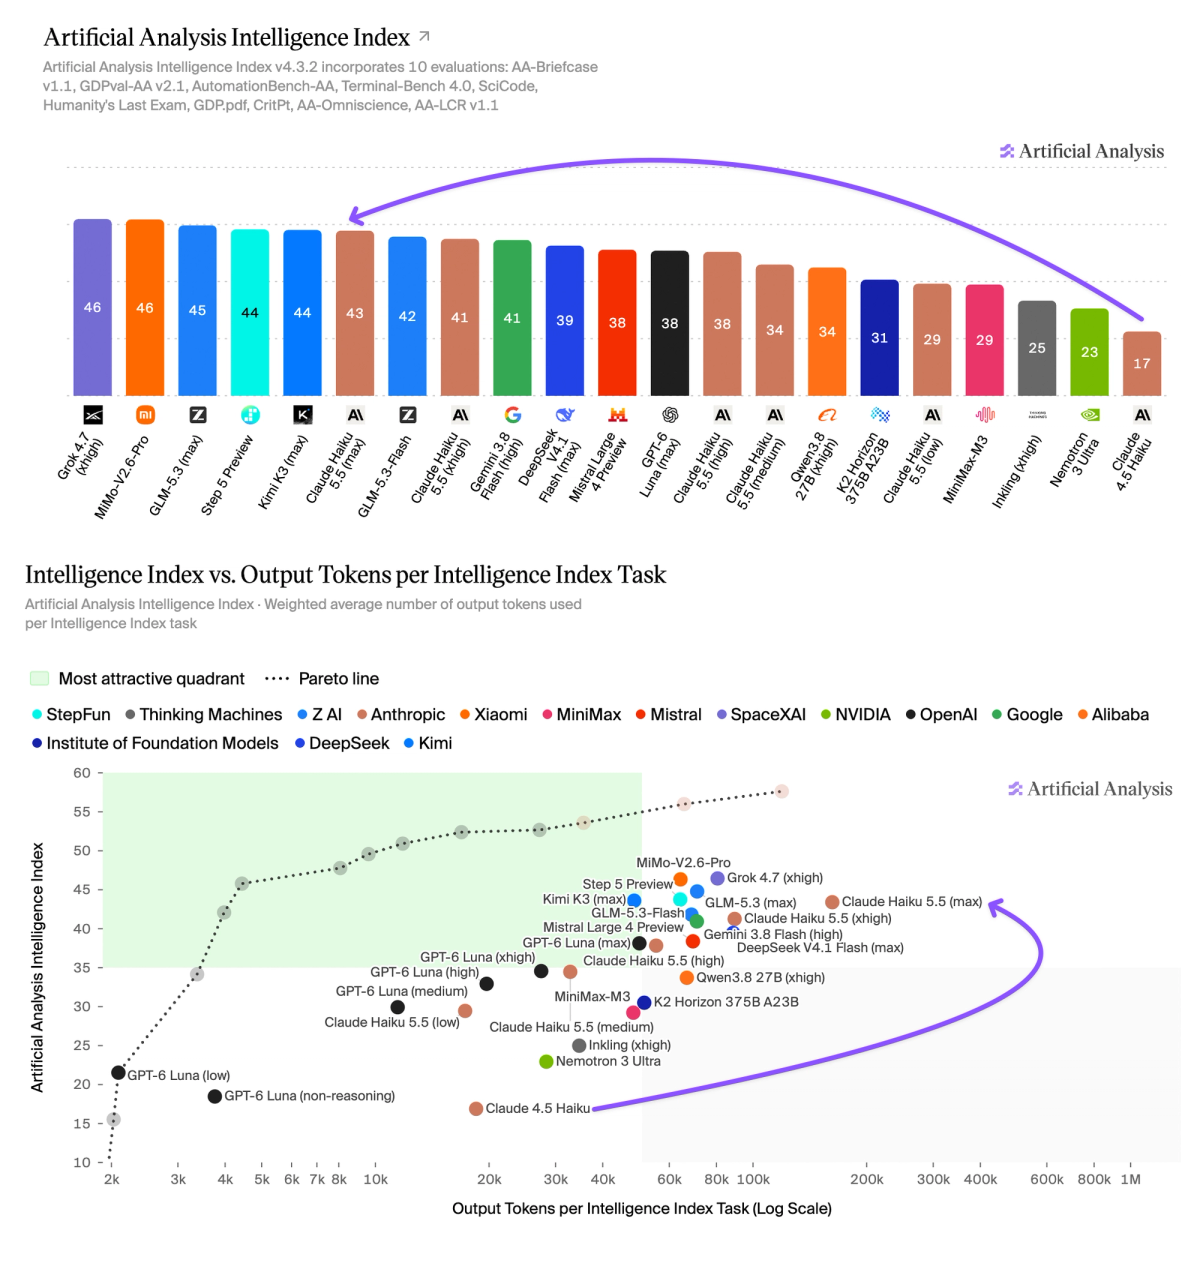
Artificial Analysis. O max marca 43, 26 pontos acima do Haiku 4.5. No gráfico de tokens, o max fica bem à direita da Luna.
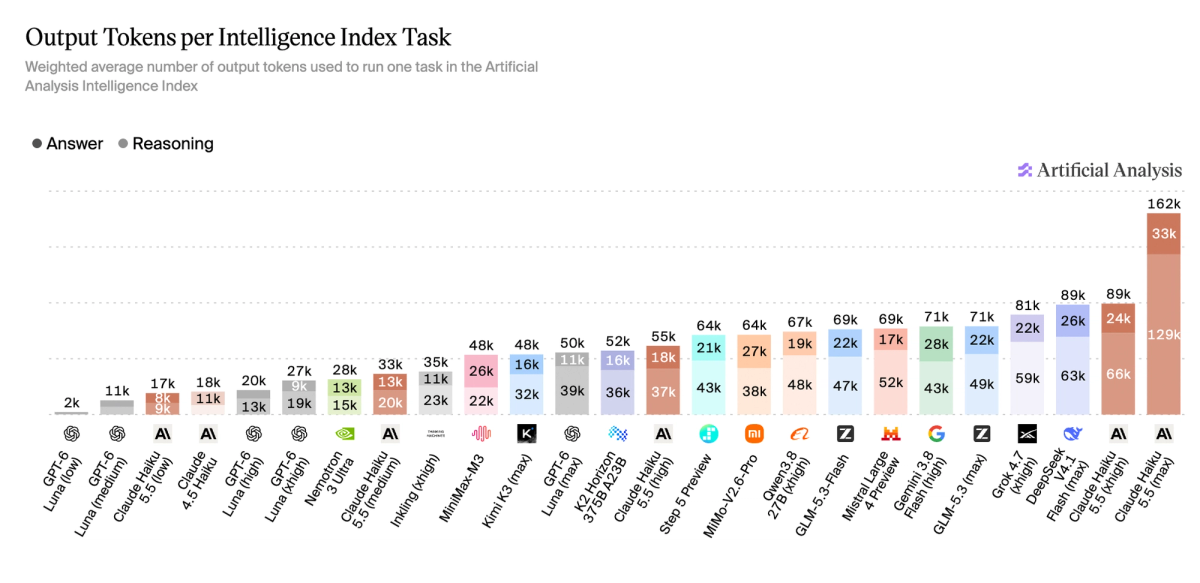
Artificial Analysis. O max usa cerca de 162.000 tokens de saída por tarefa. A maior parte dessa barra é raciocínio.
Onde a versão do lançamento justifica os tokens a mais
No AA-Briefcase, a Anthropic e a Artificial Analysis publicam 1578 Elo. O Haiku 4.5 marca 614. A Luna marca 1336. O Sonnet, na tabela da Anthropic, marca 1824. A Artificial Analysis coloca 1578 dentro do intervalo de confiança do Astra no máximo e do Fable 5.1 em high, e ao lado do Muse Spark 1.3 no máximo. Esses 1578 são a versão do lançamento. O medium é um degrau mais baixo no mesmo gráfico.
No AA-Omniscience o modelo sabe menos e inventa menos. A precisão é 36%, contra 55% do Gemini 3.8 Flash e 44% da Luna. A taxa de alucinação é 40%, contra 55% e 77%. Parte do erro é o modelo dizer que não sabe.
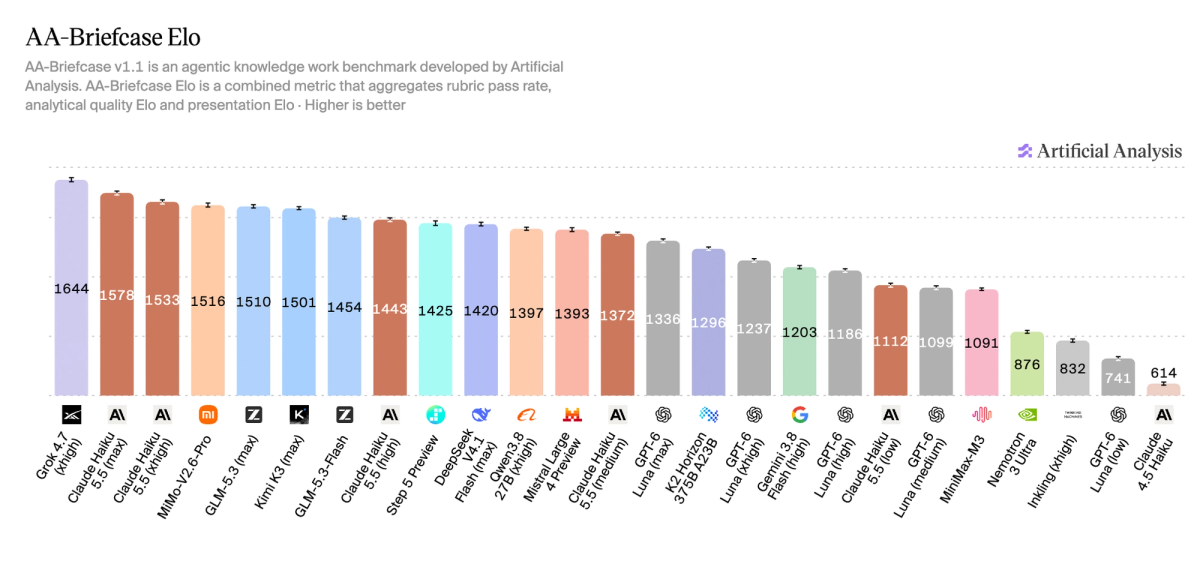
Artificial Analysis. O Haiku 5.5 no máximo marca 1578 Elo. O Haiku 4.5 marca 614. O máximo da Luna neste gráfico é 1336.
A tabela de lançamento da Anthropic é uma segunda fonte, e ela continua sem nomear o esforço do Haiku. Mantenha essa tabela separada da escada acima.
No Terminal-Bench 4.0, a Anthropic reporta 39,2% para o Haiku 5.5, 0,0% para o Haiku 4.5, 16,4% para a Luna e 70,6% para o Sonnet. A Artificial Analysis, na rodada dela, reporta cerca de 33%, no nível do GLM-5.3 Flash, à frente do Gemini 3.8 Flash em 20% e da Luna em 13%, e de novo 0% para o Haiku 4.5. São dois harnesses. O 0% é um piso. A vantagem do Sonnet é a divisão que decide para onde vai o trabalho difícil de terminal.
No FrontierCode 1.1 Main, a Anthropic reporta 46,4% para o Haiku, 42,4% para a Luna e 52,1% para o Sonnet em xhigh. Só a célula do Sonnet está rotulada. No OSWorld 2.1, subconjunto offline, o Haiku marca 72,4%, o Haiku 4.5 marca 15,7%, a Luna marca 48,9% e o Sonnet marca 83,9%. No Humanity's Last Exam, o Haiku marca 45,9% sem ferramentas e 57,4% com ferramentas. O Sonnet marca 56,9% e 64,5%. No Chartography sem ferramentas, o Haiku marca 46,4%, o Haiku 4.5 marca 6,4%, a Luna marca 29,1% e o Sonnet marca 61,6%. No GDPval-AA v2.1, o Haiku marca 1620, o Haiku 4.5 marca 735, a Luna marca 1437 e o Sonnet marca 1840.
O AutomationBench-AA pede uma espera. A Artificial Analysis mede 35%, contra 53% a 60% da Luna, do Gemini 3.8 Flash e do GLM-5.3 Flash, e diz que uma recusa de segurança da versão pré-lançamento fez o modelo recusar demais. Eles esperam uma nota mais alta na nova rodada.
O preço, depois de escolher a versão
Abaixo de 100.000 tokens de entrada, o Haiku 5.5 custa US$ 0,10 por milhão de tokens de entrada e US$ 0,50 de saída. A leitura de cache custa US$ 0,01. A escrita de cache de cinco minutos custa US$ 0,125. Esse preço de lista empata com a Luna, e fica 90% abaixo do Haiku 4.5, a US$ 1 e US$ 5. Acima de 100.000 tokens de entrada, o request inteiro custa cinco vezes isso: US$ 0,50, US$ 2,50, leitura de cache a US$ 0,05, escrita de cache a US$ 0,625. A Anthropic diz que cerca de 90% dos requests ao Haiku anterior ficavam abaixo da linha, e que um mix típico agora custa cerca de 75% menos para rodar, tokenizer incluído.
A Artificial Analysis precificou as tarefas do índice só na tarifa mais baixa. O low custa US$ 0,02 por tarefa e o max custa US$ 0,21, com uma distância de até 8,7 vezes entre os cinco esforços. Essas cifras não incluem o degrau de preço.
O mesmo lançamento corta a leitura de cache do Sonnet 5.5 de US$ 0,20 para US$ 0,10. A estimativa da Anthropic é cerca de 20% a menos na maior parte do trabalho agêntico. A entrada e a saída do Sonnet continuam em US$ 2 e US$ 10. O modelo que ainda lidera o Terminal-Bench ficou mais barato de reutilizar no dia em que o modelo pequeno chegou.
Na prática
- De fábrica você recebe o medium, e o medium marca 34. O 43, os 1578 do Briefcase e a linha de uso de computador na tabela de lançamento são a versão que você liga.
- Para um trabalho que precise empatar com a Luna, use high. Isso é 38, a cerca de 55.000 tokens de saída por tarefa do índice. O max soma 2 pontos sobre o xhigh e cerca de 1,8 vez os tokens, e uma tarefa chega a cerca de 162.000 tokens de saída.
- Deixe o Sonnet 5.5 no trabalho difícil de terminal. A divisão da Anthropic é 70,6% contra 39,2%. A leitura de cache do Sonnet agora custa US$ 0,10. O 0% do Haiku 4.5 neste bench é um piso, na tabela da Anthropic e na rodada da Artificial Analysis.
- Use o Haiku onde a tarefa é estreita e repetida: classificação, extração, compactação, roteamento e um subagente sob um modelo maior. É a carga para a qual a escada de esforço foi feita.
- Se um prompt passa de 100.000 tokens de entrada, o request inteiro vai para US$ 0,50 e US$ 2,50. Os preços de US$ 0,02 e US$ 0,21 por tarefa são a tarifa mais baixa.
- Deixe folga no max_tokens. O mesmo texto tem cerca de 30% mais tokens do que no Haiku 4.5, e o pensamento conta no limite. O pensamento pode ser desligado em low, medium e high. Em xhigh e max esse request devolve 400. Mudar o esforço entre turnos invalida o cache do prompt.
- Segure o AutomationBench em 35% até a nova rodada. A nota publicada inclui recusas em excesso.
Fontes: Introducing Claude Haiku 5.5, a Artificial Analysis, a comparação de esforço e a visão geral do modelo. A escada do índice, a tarefa de 162.000 tokens, o Briefcase em 1578 e as taxas de Omniscience são da Artificial Analysis. A tabela de lançamento é da Anthropic, e ela não nomeia o esforço do Haiku. O padrão medium e a mudança de 30% do tokenizer vêm da documentação da Claude.