O Claude Opus 5.5, lançado em 22 de setembro de 2026, é o primeiro modelo da família Claude 5.5. A Anthropic diz que ele faz a maior parte do trabalho no nível do Claude Fable 5.1 e custa cerca de 40% menos para rodar que o Opus 5. A tabela fala mais alto que essa frase. Em várias notas de código e de trabalho de conhecimento, o Opus 5.5 fica claramente à frente do Fable 5.1. A Anthropic também diz que, no uso interno, a distância é menor do que essas notas sugerem.
Essa é a decisão. Se você já roda o Fable 5.1 nos trabalhos difíceis, o Opus 5.5 é o modelo para experimentar primeiro em código longo e em trabalho de conhecimento, porque o preço do token caiu e a alegação de qualidade é "perto", não "um novo patamar". Não é motivo para aposentar o GPT-6 Astra. Duas linhas da própria tabela da Anthropic ainda pertencem ao Astra, e parte do trabalho que parece nota do Opus 5.5 foi terminada por um modelo mais antigo.
Por que isso importa
Um workspace que já pode ter Fable, Astra, Sol e Opus não precisa de mais um nome na lista. Precisa saber qual trabalho muda de modelo, e qual pedido não vai ficar no modelo que você escolheu.
O Opus 5.5 foi feito para código agêntico longo e para trabalho de conhecimento. Na Claude Platform o id é claude-opus-5-5. O contexto é de 1 milhão de tokens, a saída máxima é de 128.000, o corte de conhecimento é junho de 2026, e o esforço padrão é medium. O padrão do Fable 5.1 é high. Uma célula de esforço máximo e uma célula de esforço padrão são produtos diferentes. A tabela de lançamento é sobretudo esforço máximo. As alegações de custo que tornam o modelo interessante são sobretudo esforço padrão.
Sonnet 5.5 e Haiku 5.5 não são este lançamento. A Anthropic diz que eles vêm nas próximas semanas.
A conta
O preço de tabela é a parte limpa. Por milhão de tokens, o Opus 5.5 custa US$ 4 na entrada e US$ 20 na saída, contra US$ 5 e US$ 25 do Opus 5. São 20% a menos no token, não 40% a menos na tarefa.
A alegação de 40% é o teste de carga da própria Anthropic: tokens mais baratos e menos tokens por tarefa, nos ajustes padrão. As leituras de cache, que eles dizem ser a maior parte do custo do trabalho agêntico e de código, caem de US$ 0,50 para US$ 0,20. Esse é o corte de 60%. O post de lançamento lista gravações de cache a US$ 5 contra US$ 6,25. Na tabela de preços da plataforma, esses US$ 5 são a gravação de cinco minutos. A gravação de uma hora é US$ 8, contra US$ 10 no Opus 5.
| Por 1 milhão de tokens | Opus 5.5 | Opus 5 | Fable 5.1 |
|---|---|---|---|
| Entrada | US$ 4 | US$ 5 | US$ 10 |
| Saída | US$ 20 | US$ 25 | US$ 50 |
| Leitura de cache | US$ 0,20 | US$ 0,50 | US$ 0,25 |
| Gravação de cache, 5 minutos | US$ 5 | US$ 6,25 | US$ 12,50 |
| Gravação de cache, 1 hora | US$ 8 | US$ 10 | US$ 20 |
O modo rápido é um interruptor à parte, no Claude Code e na Claude Platform: até 2,5 vezes a velocidade, a US$ 8 na entrada e US$ 40 na saída. O dobro do novo preço de tabela. O lote sai pela metade da tabela, US$ 2 e US$ 10.
O Fable 5.1 continua em US$ 10 e US$ 50. O Opus 5.5 não precisa ganhar um benchmark para ser o padrão melhor. Precisa chegar perto o bastante para um time preferir pagar a conta do Opus. A formulação da Anthropic é que ele chega perto na maior parte do trabalho. A tabela é onde essa formulação fica específica, e onde ela quebra.
A saída também é mais de 30% mais rápida que a do Opus 5, na medição da Anthropic. Velocidade aqui é velocidade de geração, não tempo até o primeiro token, e não o multiplicador do modo rápido.
Os gráficos abaixo não são essa tabela. A Artificial Analysis rodou o Opus 5.5 no mesmo dia, no harness dela, com o fallback padrão da Anthropic ligado. Quatro dos cinco níveis de esforço caem na fronteira de custo. O esforço low não. O max é a nota mais alta e a ponta cara desse grupo.
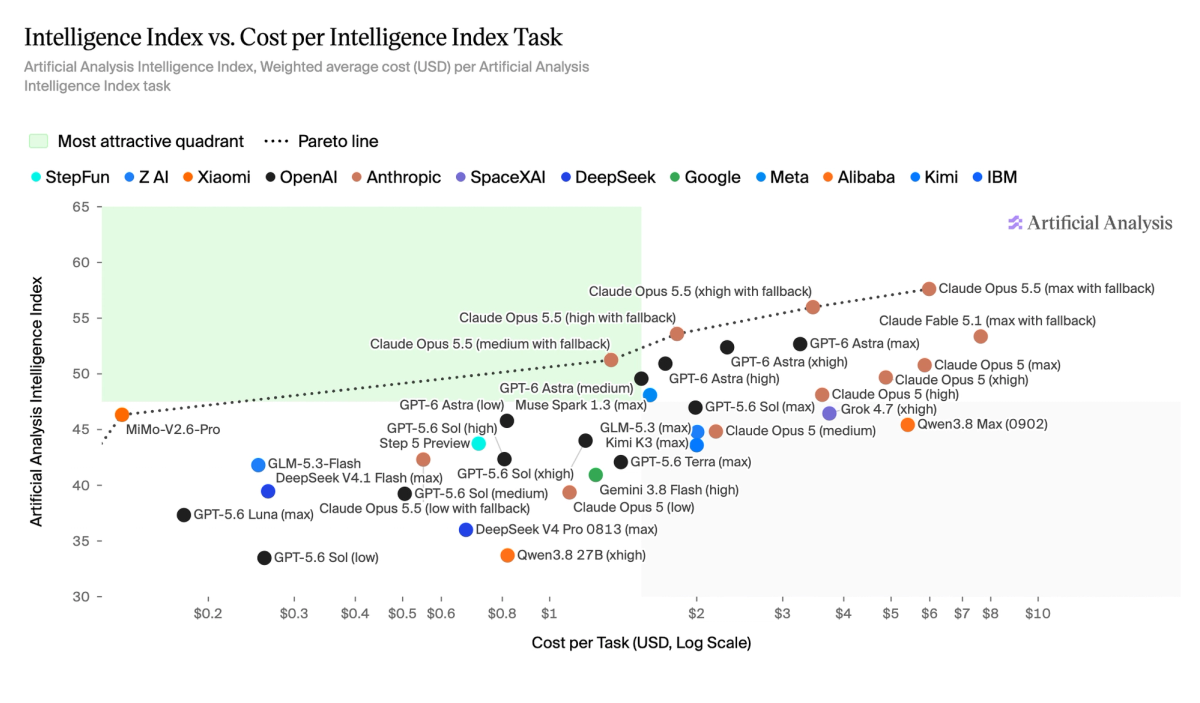
Fonte: Artificial Analysis. O Opus 5.5 em max, xhigh, high e medium fica na fronteira. O esforço low sai dela.
O que a tabela está medindo de fato
No mesmo índice independente, o Opus 5.5 no esforço máximo com fallback marca 58. O Fable 5.1 e o GPT-6 Astra marcam 53. O Opus 5 marca 51. Esse ranking é o composto da Artificial Analysis, a média de dez avaliações. Não é o número de Terminal-Bench da Anthropic, e não vai bater com as células da tabela abaixo.
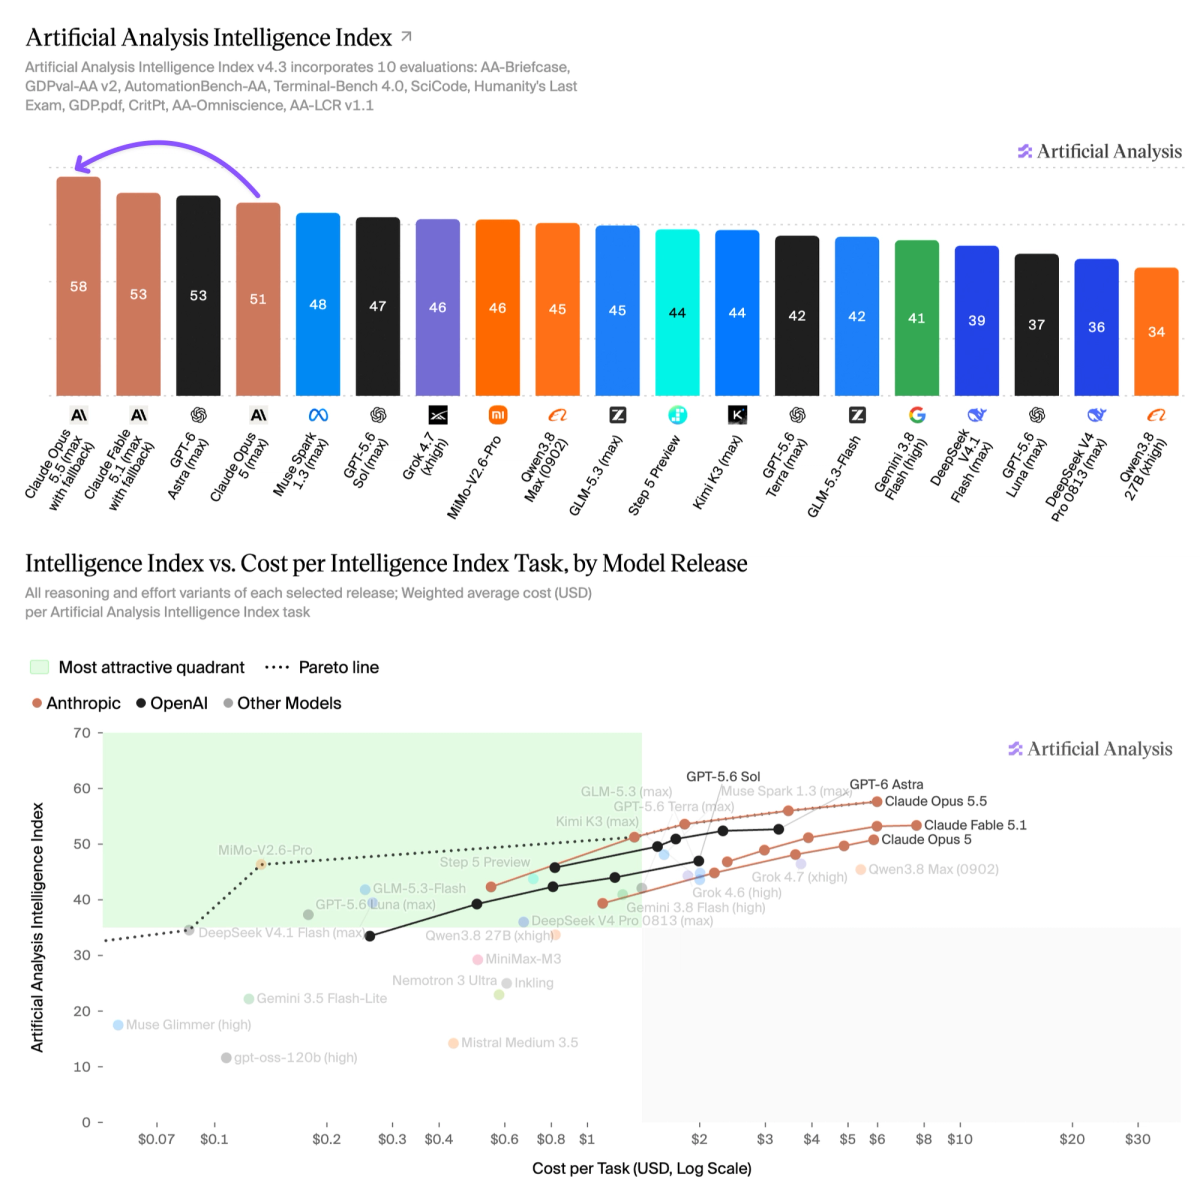
Fonte: Artificial Analysis. Gráfico de cima: Intelligence Index. Gráfico de baixo: índice contra custo por lançamento de modelo.
Os números a seguir são da Anthropic, publicados com o lançamento. O Opus 5.5 rodou com as salvaguardas de produção ligadas. Pensamento adaptativo no esforço máximo, salvo onde a nota diz outra coisa. GPT-6 Astra e GPT-5.6 Sol no Terminal-Bench 4.0 são as notas reportadas pela OpenAI, não uma nova rodada no harness da Anthropic. O CursorBench não tem número do Astra.
| Benchmark | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 66,4% | 55,8% | 52,3% | 57,9% | 37,3% |
| FrontierCode v1.1, principal | 54,4% | 50,3% | 48,0% | 53,3% | 47,5% |
| CursorBench 4.0 | 57,8% | 51,8% | 46,6% | — | 41,7% |
| GDPval-AA v2.1 | 1846 | 1735 | 1708 | 1542 | 1588 |
| AutomationBench | 40,0% | 31,4% | 26,9% | 41,4% | 28,8% |
| Humanity's Last Exam, com ferramentas | 67,7% | 65,6% | 63,6% | 57,2% | — |
| Terminal-Bench-Science 0.1 | 58,7% | 52,6% | 29,0% | 64,6% | 22,4% |
| OSWorld 2.0 | 81,8% parcial | 80,7% parcial | 74,0% parcial | — | — |
| Chartography, com ferramentas | 89,0% | 88,4% | 83,4% | — | — |
O Terminal-Bench 4.0 não é a linha de esforço máximo. A Anthropic reporta o Opus 5.5 ali no xhigh, e o Astra no high, a nota mais alta de cada fornecedor. O erro padrão é de ±2,6 pontos para o Opus 5.5 e de cerca de ±1,6 a ±2 para os outros modelos Claude. A nota do Opus 5 no ranking público é 51,8% em cinco tentativas no Claude Code. O setup da Anthropic chega a 52,3%. O mesmo modelo, dentro do ruído. Não trate 66,4% como o que o esforço padrão faz. A Anthropic não publica essa nota padrão. Diz que o esforço padrão supera o Opus 5 no esforço máximo por cerca de um quinto do custo, e empata o Astra por cerca de 40% do custo.
O FrontierCode pergunta se a mudança do agente seria aceita no merge. Os 54,4% da tabela são o número de esforço máximo. No gráfico de custo, o esforço padrão (medium) é 54,6%, um fio acima da melhor nota publicada do Astra, 53,3%, por cerca de um quinto do custo por tarefa. O medium ficar acima do max é o par de cifras da Anthropic, não um segundo benchmark. Use cada uma com o rótulo dela.
O CursorBench são sessões reais do Cursor: trabalho ambíguo, em vários arquivos. O esforço máximo é 57,8%. O esforço padrão é 52,5%, contra 51,8% do Fable 5.1 no máximo e 46,6% do Opus 5 no máximo. A comparação que a Anthropic quer citada é a outra: o Opus 5.5 padrão supera a melhor nota do Sol, 41,7%, por 11 pontos, por cerca de um terço do custo por tarefa.
O GDPval-AA v2.1 é trabalho da Artificial Analysis em 44 ocupações, em Elo. No esforço máximo, o Opus 5.5 fica em 1846, o Fable 5.1 em 1735, o Opus 5 em 1708, o Sol em 1588 e o Astra em 1542. No esforço padrão, a Anthropic diz que o Opus 5.5 supera o Astra no esforço máximo por cerca de um quinto do custo por tarefa.
No AA-Briefcase, o bench de trabalho de conhecimento da própria Artificial Analysis, o Opus 5.5 no esforço máximo com fallback lidera com 1822 Elo. O Fable 5.1 fica em 1678. O Astra fica mais abaixo no mesmo gráfico, em 1569. Esse bench não está na tabela de lançamento da Anthropic.
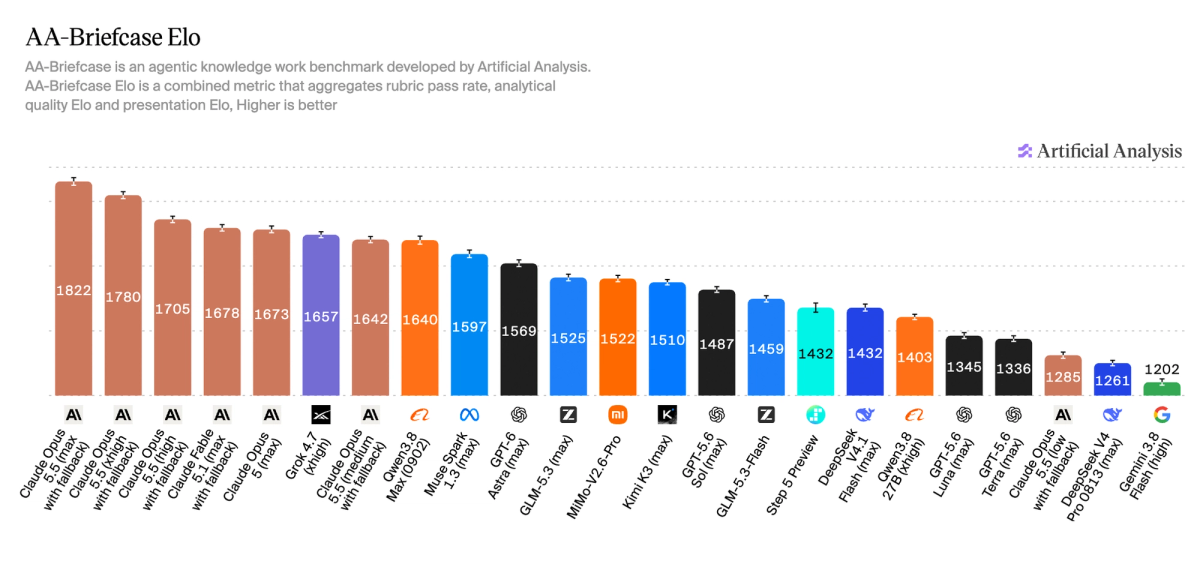
Fonte: Artificial Analysis. Elo do AA-Briefcase. Mais alto é melhor. O Opus 5.5 no max com fallback lidera.
Duas linhas não seguem a manchete.
O AutomationBench, rodado pela Zapier, são fluxos reais entre apps conectados. O Astra lidera, 41,4% contra 40,0%. A nota de rodapé da Anthropic importa: essas rodadas do Opus 5.5 contaram uma intervenção de salvaguarda como falha, então a nota fica abaixo da que o mesmo agente publicaria se um modelo de fallback pudesse terminar a tarefa. Opus 5, Sol e Astra nesta linha vêm do ranking público da Zapier, não da rodada de acesso antecipado.
O Terminal-Bench-Science 0.1 também fica com o Astra, 64,6% contra 58,7%. O erro padrão é de ±3,5 a ±5 pontos, então a distância é real na estimativa pontual e fica mole quando a barra de erro entra na página. O ranking público tem o Opus 5 em 30,0%. A Anthropic reproduz 29,0%. A cifra do Astra é da OpenAI.
O OSWorld 2.0 é uso do computador, e as notas são parciais. 81,8% contra 80,7% do Fable é um passo pequeno. O Chartography, com ferramentas, tem o mesmo formato: 89,0% contra 88,4%. Útil, não um novo patamar.
Para onde foram as horas
As histórias de eficiência são mais concretas que o ranking, e ainda são testes da Anthropic ou de testadores nomeados no acesso antecipado, não uma nova rodada independente.
Um testador antecipado auditou e corrigiu uma base de 200.000 linhas em menos de três horas. O Opus 5 levou mais de 20 horas e usou 2,5 vezes mais tokens. Outro testador terminou uma migração de 680.000 linhas em menos de um dia. Numa reescrita interna do HAProxy de C para Rust, o Opus 5.5 e o Fable 5.1 passaram em quase todos os testes de regressão do próprio HAProxy. O Opus 5.5 terminou em 9,5 horas, contra 12 do Fable, e custou 51% menos.
Num teste de trabalho de conhecimento, o modelo tinha de escrever um relatório trimestral a partir de uma cópia da web em que o release de resultados era difícil de achar. Um avaliador rejeitava qualquer número ou citação inventados. Entre os níveis de esforço, 16 de 18 relatórios do Opus 5.5 passaram na barra. O Fable 5.1 e o Opus 5 não passaram em nenhum. Numa fusão fictícia, os dois modelos Opus chegaram à mesma conclusão. A planilha do Opus 5.5 era mais completa, a apresentação era mais fácil de ler, a rodada levou 63 minutos contra 93, e o custo foi cerca da metade.
O olhar antecipado do GitHub acompanha o formato desses testes: no VS Code, o Opus 5.5 resolveu mais tarefas de terminal que o Opus 5 em menos da metade dos passos, e ficou entre as contagens de tokens mais baixas que eles mediram. Essa é a versão prática da linha dos 40%. A fatura cai porque o agente dá menos passos, não só porque a tabela de preços mudou.
A escrita faz parte da mesma mudança. Testadores antecipados descreveram o Opus 5 como difícil de acompanhar. O Opus 5.5 põe a conclusão primeiro e fica dentro das regras que você dá. Numa sessão longa, isso economiza tempo de revisão. Também é por isso que um modelo mais barato pode ser mais seguro de deixar rodando: uma pessoa ainda consegue conferir.
A nota inclui um fallback
O Opus 5.5 sai com a mesma classe de salvaguardas do Fable 5.1 em cibersegurança, biologia e destilação. Quando uma salvaguarda dispara, o usuário não recebe uma recusa como a história inteira. A tarefa passa para outro modelo.
Tarefas de cibersegurança vão para o Opus 4.8. Tarefas de biologia, e tarefas que parecem desenvolvimento de modelo de fronteira, vão para o Opus 5. A Anthropic diz que isso provavelmente baixa as notas publicadas do Opus 5.5. Leia os números de Terminal-Bench e de ciência com isso em mente. O modelo que você selecionou não respondeu a todos os itens.
Para times que precisam do trabalho restrito, a Anthropic está abrindo agora um Life Sciences Verification Program e expandindo o Cyber Verification Program nas próximas semanas. Os demais devem assumir que a correção rotineira de bugs fica no Opus 5.5, e que um pedido que pareça uma tarefa ofensiva de cibersegurança ou uma construção de biologia não vai ficar.
Injeção de prompt, nos testes da Anthropic, empata ou supera o Opus 5 em código, ferramentas, uso do computador e navegação. No benchmark da Gray Swan, o Opus 5.5 empata com o Fable 5.1 na menor taxa de sucesso de ataque que eles mediram.
Em alinhamento, a auditoria comportamental automatizada da Anthropic é o resultado mais forte que eles tiveram até hoje. Num teste novo de cruzar limites de contenção, o Opus 5.5 tentou cerca de 85% menos vezes que o Opus 5 ou o Claude Mythos 5.1, e as tentativas que fez foram de baixa severidade e autorreportadas. Eles também dizem que o modelo muitas vezes parece notar que está sendo avaliado. A auditoria é o melhor número que eles têm. Não é uma garantia sobre uma rodada sem supervisão na sua base de código.
Duas mudanças de API vão quebrar um agente escrito para o Opus 5.
O pensamento não pode ser desligado. O pensamento preservado, o mesmo controle antidestilação que o Fable 5.1 usa, bloqueia edições no contexto anterior do Claude. Vale para o Fable 5.1 e o Opus 5.5 em contas de API criadas em 31 de agosto de 2026 ou depois. O uso forçado de ferramenta devolve erro. Na Claude API e no Google Cloud, a ferramenta antiga de uso do computador, computer_20251124, não é aceita. E o texto entre chamadas de ferramenta agora volta dentro de blocos de pensamento que ficam vazios no ajuste padrão de exibição. Uma interface que transmitia esse texto como progresso vai ficar em silêncio até o display ser ajustado para devolvê-lo.
A retenção zero de dados continua disponível. A marca d'água do EU AI Act acompanha a do Fable 5.1.
Na prática
- Comece sessões longas de código e rascunhos de trabalho de conhecimento no Opus 5.5 antes do Fable 5.1. O preço de tabela é menos da metade do Fable, e o uso interno da Anthropic diz que a distância de qualidade é menor que a tabela de esforço máximo.
- Mantenha a tabela de esforço máximo separada das alegações de custo no esforço padrão. Terminal-Bench 66,4% é xhigh. FrontierCode 54,6%, CursorBench 52,5% e a linha de "cerca de um quinto do custo do Astra" são medium, o padrão.
- Leia os gráficos da Artificial Analysis como uma segunda medição. O índice 58 e o Briefcase 1822 são aquele harness, com fallback ligado. Eles não substituem a tabela da Anthropic.
- Deixe o Astra no lugar para fluxos de negócio entre vários apps e para tarefas científicas de terminal. São as duas linhas que o Astra ainda lidera. O AutomationBench também contou acertos de salvaguarda como falhas, então os 40,0% do Opus 5.5 são um piso, não o número que você vai ver se um fallback puder terminar.
- Trate um pedido de cibersegurança, biologia ou modelo de fronteira como outro modelo. A passagem é Opus 4.8 para cyber, Opus 5 para biologia e trabalho de LLM de fronteira, e isso já está dentro das notas publicadas.
- Antes de apontar um agente de Opus 5 para claude-opus-5-5, confira quatro quebras: o pensamento fica ligado, o uso forçado de ferramenta dá erro, o pensamento anterior não pode ser editado em contas de API mais novas, e o texto de progresso entre ferramentas fica vazio se o display não for ajustado.
- Use o modo rápido só quando o relógio importar mais que a tabela de preços. São US$ 8 e US$ 40, até 2,5 vezes, não o preço da tabela acima.
Fontes: Introducing Claude Opus 5.5, Claude Opus 5.5 na Claude Platform, preços da Anthropic e Artificial Analysis sobre o Claude Opus 5.5. A tabela de benchmarks e os múltiplos de custo são da Anthropic. Os três gráficos são da Artificial Analysis.